AI Agent 的三個迴圈:從 ReAct、Reflexion 到 Generative Agents
從 ReAct、Reflexion 與 Generative Agents 理解行動、回饋與記憶,對照 Heptabase、Codex 到網站發佈的實作選擇與驗收問題。
這篇文章由 AI 先生成草稿,再經人工審閱與發布。
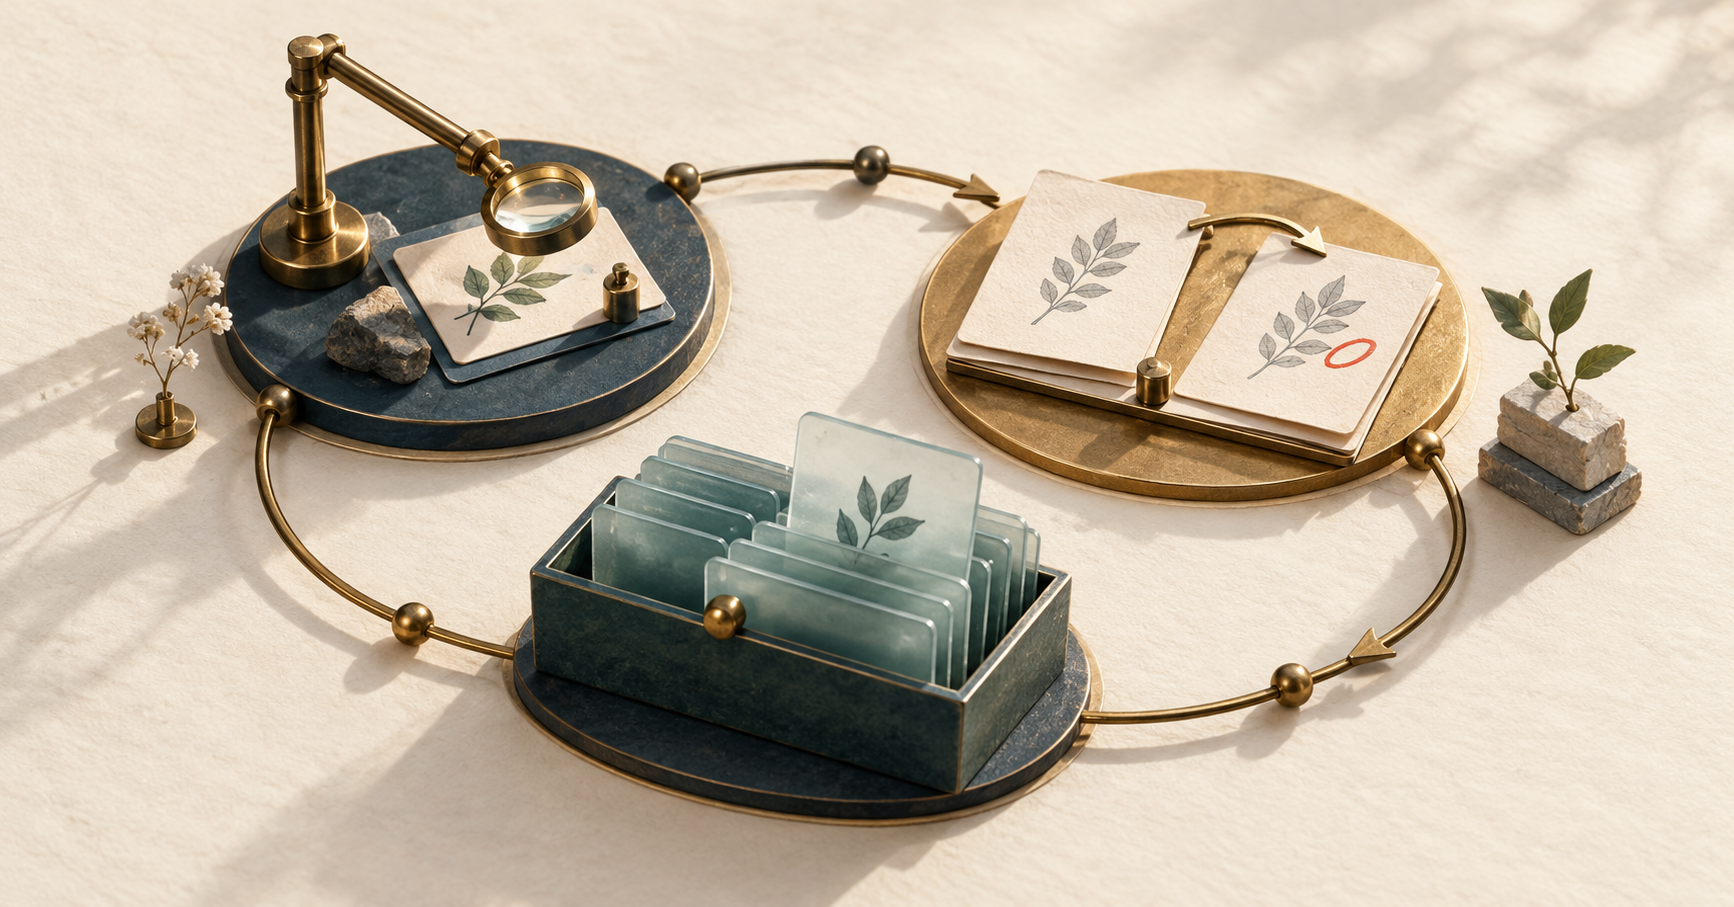
上一篇,我整理了自己的工具分工:Heptabase 保存知識,Codex 執行,Git 與 personal-site 承接發佈。分工確定之後,我更想知道:Agent 在一次任務中,如何知道下一步該做什麼?失敗之後,又有什麼值得留下?
我從已收藏的論文中選了 ReAct、Reflexion 與 Generative Agents。這三篇發表於 2022–2023 年,適合拿來理解基礎機制。本篇依固定的 arXiv 版本閱讀,沒有重跑實驗,也不把不同任務的 benchmark 分數排成能力榜。
我把它們整理成三個時間尺度:當下的行動、下一次嘗試,以及之後的任務。「三個迴圈」是我的閱讀框架;三篇並未共同提出一套完整的發佈系統。
| 閱讀視角 | 論文 | 我想回答的問題 |
|---|---|---|
| 當下的行動 | ReAct | 工具回傳新資訊後,下一步要怎麼改? |
| 下一次嘗試 | Reflexion | 哪一條失敗回饋,能讓修訂更具體? |
| 之後的任務 | Generative Agents | 哪些經驗值得保存,又該在什麼時候取用? |
ReAct:讓觀察影響下一個動作
ReAct 將推理與行動交錯,讓工具或環境回傳的觀察參與後續決策。論文在問答、事實查核與互動任務中評估這種做法,也記錄了無效檢索和重複行動造成的失敗。接上工具,仍需要判斷取回的資訊是否有用。ReAct v3,§2–3
對我的研究流程而言,這可以落成一個很小的動作:讀完 Heptabase 舊筆記,發現某個結論沒有版本資訊,就回到原始論文核對;如果來源不足以支持結論,就縮小主張或繼續補查。
我會留下「查了哪個來源、得到什麼結果、還缺什麼證據」。這些紀錄能幫我判斷工作是否前進。對同一個查詢反覆得到相同片段時,下一步應該改查詢、換來源,或明確標示尚無答案。
Reflexion:把回饋寫成下一輪能用的修訂依據
Reflexion 讓執行者取得評估回饋,再把文字反思放入記憶,供後續嘗試使用。這個過程沒有透過梯度更新模型權重。論文也指出,錯誤的自生測試可能讓系統接受錯誤答案;附錄的 WebShop 實驗沒有顯示明顯改善。Reflexion v4,§3、§4.3、附錄 B
把這個想法用在寫作,我會將「這段不夠好」改成可驗收的回饋。例如:
草稿把模擬角色的行為可信度,寫成工作助理的正確率。下一版應改回論文實際評估的目標,補上來源,並把自己的應用推論分開。
這是示意回饋,不是本次重跑的實驗紀錄。修訂後要回查原文,確認同一個問題已經修正。模型寫出的自評可以提出檢查方向;稿件是否通過,仍由來源、可執行檢查與人的審閱決定。
在這個工作流中,我也會為修訂設定停止條件:已有足夠依據就進入審閱;缺資料就記下缺口。持續改寫本身,不能作為品質提升的證據。
Generative Agents:讓記憶在需要時回到任務
Generative Agents 在一個有 25 個角色的模擬小鎮中,結合記憶、反思與規劃。檢索考慮相關性、重要性與近期取用;反思則把經驗整理成較高層的推論。它的評估重點是行為可信度,作者也觀察到檢索失誤與記憶內容被添寫的問題。Generative Agents v2,§4、§6、§8.2
對我的第二大腦,最有用的啟發是替記憶保留身分。論文原文支持的事實、某次工作的結果、我已確認的偏好,以及 AI 提出的推論,應該看得出差別。
例如,「發文前要先看全文、圖片與 LinkedIn 摘要」是我已確認的流程偏好,可以供下次任務取用。「這次文章已上線」則需要那次發佈的網址與結果紀錄。如果日後改變流程,也要讓新的決定能取代舊規則。
Heptabase 的卡片與連結提供了保存這些內容的位置。這不代表我的系統已實作論文的檢索評分或自動反思架構;我借用的是整理與使用經驗的設計思路。
放回我的發文流程,各工具承接什麼?
以下是我依目前工作方式做的應用整理,並非三篇論文驗證過的產品組合。
| 工具 | 承接的內容或動作 |
|---|---|
| Zotero | 原始論文、書目與 PDF,讓引用有可回查的版本 |
| Heptabase | 閱讀筆記、來源關係、可編輯草稿與已確認的經驗 |
| Codex | 查核、撰寫、產圖、整理審閱包,以及核准後的執行與驗證 |
| Git/personal-site/GitHub Actions | 保存公開產物、版本差異,建置並部署網站 |
| 網站上線後,發出已審閱的短摘要與全文連結 | |
| Bitwarden Secrets Manager | 在執行時提供發文憑證 |
| Linear/Slack | 需要追蹤交付時用 Linear;有授權與明確目的地時用 Slack 溝通 |
Content Studio 已退出這條流程。單純準備一篇文章,也不需要先建立 Linear issue。
以這次三篇論文的文章為例,Codex 先讀既有筆記,再回到原文補足查核。這一步參考 ReAct 的行動迴圈。接著產出中英文全文、封面與 LinkedIn 摘要,依具體回饋修訂;這裡借用 Reflexion 的思路。值得保留的寫作規則與來源關係,再整理回 Heptabase,供之後取用。
到了發佈階段,我採用已定義好的程序:先審閱指定版本,確認後才推送 Git、觸發 CI/CD;驗證中英文頁面上線後,再送出該版 LinkedIn 摘要。中途若出錯,就讀取已完成的步驟與結果,決定從哪裡恢復。
內容判斷可以反覆探索;對外發佈需要明確的版本、授權與完成證據。 這是我從論文閱讀延伸出的工程選擇。
下一步,我想用什麼方式驗證?
我會先挑一個反覆遇到的小任務,檢查三件事:
- 筆記過期時,Agent 能否找到新來源,並說明哪些結論需要更新?
- 收到具體回饋後,下一版是否修正同一個問題,而沒有弄丟原本正確的內容?
- 下一次開新任務時,能否取用已確認的新規則,並指出依據?
這些是接下來的驗收題目,尚未形成對照實驗。要判斷方法是否有效,我還需要記錄來源正確性、重複錯誤、修訂回合與人的審閱時間。
讀完這三篇,我更在意每一步能留下什麼可檢查的結果:行動有觀察、修訂有依據、記憶有來源。這也是我希望自己的 Agent 工作流逐步做到的事。
本篇閱讀版本
- Yao 等,ReAct: Synergizing Reasoning and Acting in Language Models。首次公開於 2022 年;本篇採 arXiv v3,2023-03-10,另見作者專案。
- Shinn 等,Reflexion: Language Agents with Verbal Reinforcement Learning。本篇採 arXiv v4,2023-10-10,另見作者程式碼。
- Park 等,Generative Agents: Interactive Simulacra of Human Behavior。本篇採 arXiv v2,2023-08-06。
延伸閱讀:我的 AI 工作流減法:讓知識、任務與發佈各有歸屬。
本文由我選定發佈方向,Codex 協助文獻整理、草稿與封面製作;技術應用段落是閱讀後的設計判斷。
延續閱讀相關文章,沿著同一組技術脈絡繼續往下看。
我的 AI 工作流減法:讓知識、任務與發佈各有歸屬
退役自製 Content Studio 後,我如何讓 Zotero、Heptabase、Linear、Codex 與 Git 各自承接文獻、知識、任務、執行和發佈,並保留圖片與全文審閱的最後一步。
從 Automation Job 到 Content Control Plane:為什麼 personal-site growth 需要一條可治理的內容閉環
AIPW 真正被產品化的,不是 AI 幫你寫文章,而是把 automation、Inbox、Topics、Drafting、Distribution、Performance 收斂成同一條 article-centric workflow,讓 personal-site growth 從零散操作變成可治理、可觀測、可優化的內容系統。
學 Observability,請親手追完一次故障
從一次可重現的 DB lock 實驗,理解 Monitoring 與 Observability 如何互補、六個演進階段、Grafana Labs 工具分工,以及從症狀到恢復驗證的學習方法。