學 Observability,請親手追完一次故障
從一次可重現的 DB lock 實驗,理解 Monitoring 與 Observability 如何互補、六個演進階段、Grafana Labs 工具分工,以及從症狀到恢復驗證的學習方法。
這篇文章由 AI 先生成草稿,再經人工審閱與發布。
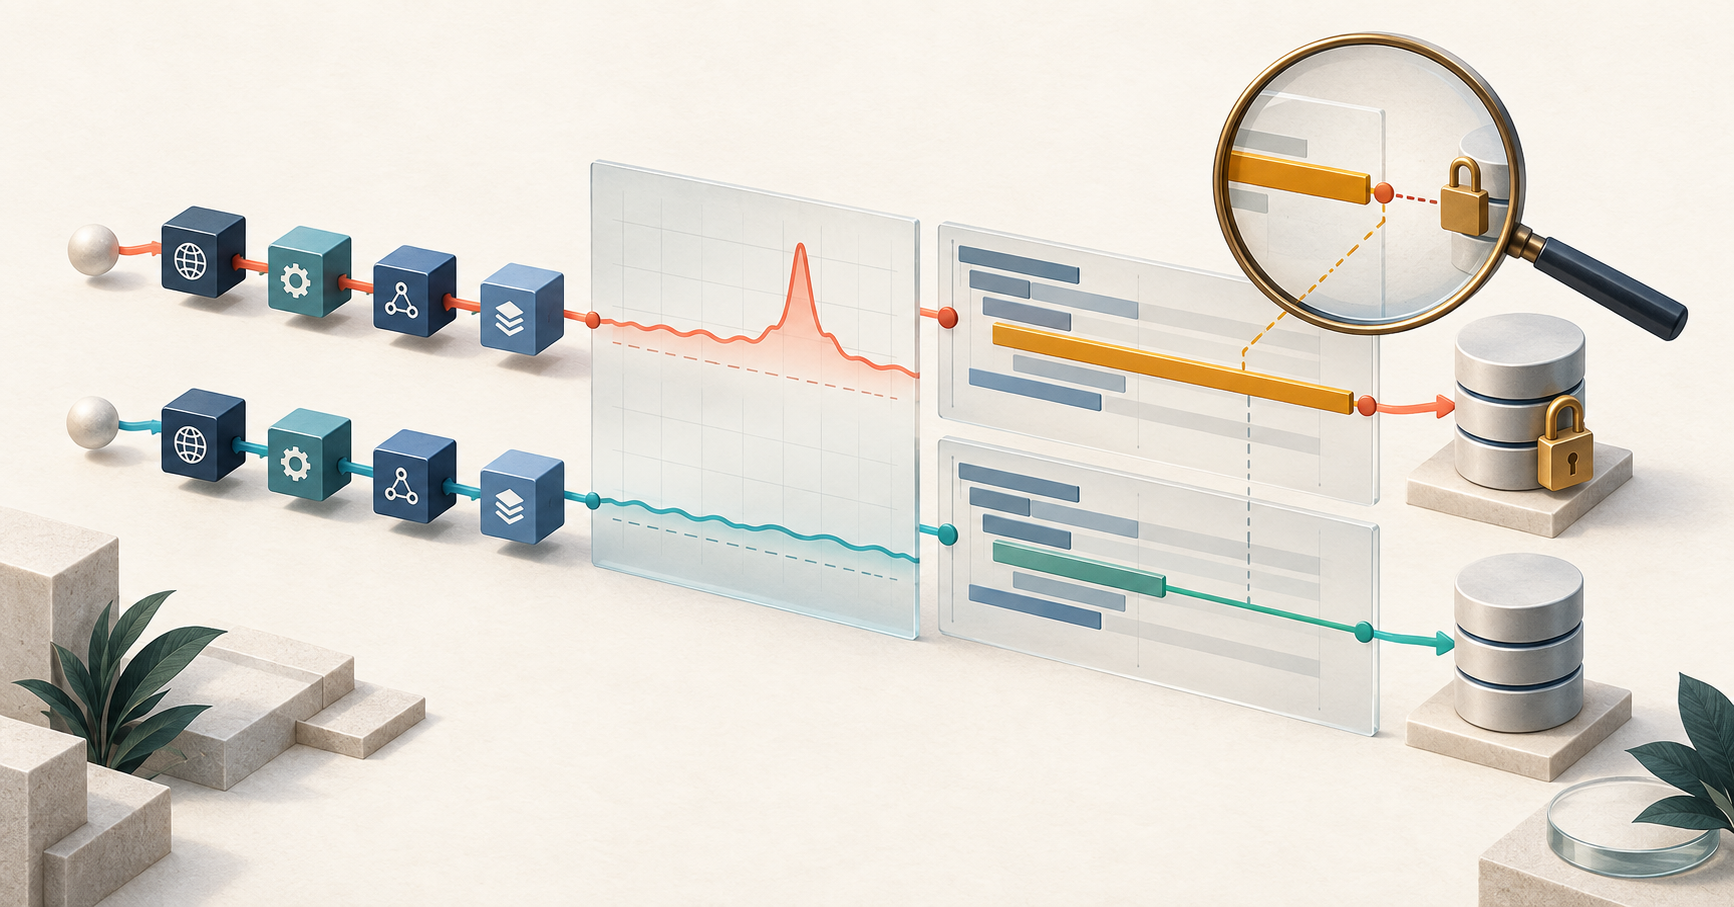
學 Observability,請親手追完一次故障
把 Grafana、Loki、Tempo 裝起來,是一個很好的開始。
接著,請挑一筆失敗的請求,解釋它經過哪裡、時間花在哪裡,以及什麼證據支持你的判斷。
這是我這次整理 Observability 學習路線時,想替自己保留的驗收標準:從症狀走到可驗證的原因,再用相同條件確認恢復。
為了把概念落地,這次透過 Codex 協助建置並執行了一個 Grafana Labs 教學 Lab。API 的 P95 延遲從 7.33 ms 升到約 3 秒,解除資料庫鎖定後回到 8.59 ms。這組數字讓 Metrics、Traces、Logs 與 Profiles 有了共同的調查情境。
如果你也正在學可觀測性,我建議從這種能完整追完的問題開始。
Monitoring 與 Observability,一起完成調查
Monitoring 持續檢查服務的健康、趨勢與目標;Observability 則關注我們能否從系統留下的訊號,理解內部發生的事情。兩者相互補充。這是依 OpenTelemetry 概念導論 整理的理解方式。
「知道壞了」與「理解為什麼壞」很適合當開場,但真正的工作會交疊。監控也能支援除錯;調查過程也可能產生新的告警規則。Google SRE 對 Monitoring 的用途,就包含回溯分析與除錯。來源:Monitoring Distributed Systems
例如,結帳變慢時,我會先關心成功率、延遲與受影響範圍,再追問:是所有請求都慢,還是特定版本、路徑或依賴出問題?
前一組問題幫助決定是否需要處置,後一組問題幫助縮小調查範圍。
有用的可觀測性,應該讓下一個問題有證據可以查。
用六個階段理解演進
整理發展脈絡時,我把觀察範圍的擴大分成六個階段:
| 階段 | 觀察焦點 | 學習時可以追問 |
|---|---|---|
| 基礎設施監控 | 主機、程序、網路、容量 | 服務活著,是否就代表請求成功? |
| APM | 應用交易、SQL、runtime | 哪個操作出現異常? |
| 分散式與雲原生觀測 | 跨服務請求與動態依賴 | 同一筆請求在哪一段等待? |
| 開放標準 | 共用埋點、傳輸與語意 | 不同服務是否保留一致的 context? |
| 跨訊號調查與治理 | 指標、事件、請求、版本 | 能否連起線索,並控制資料成本? |
| 更深的觀測與輔助分析 | Profiles、eBPF、RUM、AI | 還缺什麼證據,推論又有哪些限制? |
這裡的「六個世代」是教學分期,各階段重疊發展,能力持續累積。APM、Tracing、Profiling 都有更早的歷史,不能把表格讀成技術首次出現的年表,也不需要把最後一列當成每個團隊的必經終點。
其中一個明確的歷史節點,是 2019 年 OpenTracing 與 OpenCensus 合併成 OpenTelemetry,讓開放埋點工作朝共同方向整合。來源:Google 合併公告
對學習者而言,這條路線的意義是逐步擴大能回答的問題:從一台機器,到一次請求,再到使用者感受到的結果。
四種訊號,要帶著問題讀
| 訊號 | 我會拿它回答什麼 | 判讀時要保留的限制 |
|---|---|---|
| Metrics | 影響多大、持續多久、趨勢如何? | 聚合資料通常無法還原每筆請求 |
| Traces | 請求經過哪些操作,時間落在哪裡? | 慢 span 只指出耗時位置,原因仍待查證 |
| Logs | 當時出現哪些錯誤、事件與狀態? | 缺少 context,可能無法對回同一請求 |
| Profiles | 哪些函式消耗哪類資源? | CPU 樣本比例不等於請求的總等待時間 |
前三種訊號的定義可見 OpenTelemetry Signals;持續效能剖析可見 Pyroscope 介紹。表中的提問與限制,是這次學習時使用的判讀方式。
資料能否關聯,還需要共用的服務名稱、環境、版本、時間與請求 context。OpenTelemetry 提供埋點與資料傳送所需的共同能力,後端則負責各自的儲存與查詢。來源:What is OpenTelemetry?
我希望練熟的動作很具體:找到慢請求,讀懂 span 關係,再用相同 trace ID 查事件。每一次跳轉,都能說明自己保留了哪些篩選條件。
從三層到五層:把遙測管道拆開看
知道有哪些訊號之後,下一步是追問:資料從哪裡產生,經過什麼處理,最後由誰使用?
向團隊說明時,可以先用三層模型抓住主線:Produce → Collect → Consume,也就是產生、收集與使用。SDK 或自動埋點產生資料,Collector 收集與處理,後端和 Grafana 讓人查詢、分析與採取行動。
要落到設計與除錯,再把這條主線展開成五個面向:Instrumentation、Signals、Transport、Collection / Processing、Backend / Analysis。這是本文的教學拆法,並非 OpenTelemetry 官方規定的五層架構,也不表示需要五個獨立服務。
① Instrumentation:誰產生資料?
手動埋點、函式庫整合、自動埋點與 profiler,決定能觀察到哪些操作。eBPF 也能在支援的環境補充自動觀測,但覆蓋範圍仍受 runtime、協定及工具能力限制。
例如一筆慢請求,必須先有對應的 span、事件或量測,後端才有資料可查。安裝 Collector 不會自動補出應用程式未曾產生的業務資訊。
② Signals / Data:產生的是什麼資料?
Metrics、Logs、Traces 與 Profiles 是不同的資料視角。它們描述量測、事件、操作關係與程式資源使用,不能當成四個收集工具,也不能理解成資料會依序從 Metric 變成 Log,再變成 Trace。
這裡的「資料層」貫穿整條管道;服務身分、語意、單位與 context 都需要一致。Profiles 已有實用工具,但截至 2026-09-20 查核的 OTLP 規格,Profiles 協定仍標示 Development;不能直接假設與另外三種訊號具有相同的標準成熟度或元件支援。
③ Transport:用什麼協定搬運?
OTLP 是 OpenTelemetry 的遙測傳輸協定,常見形式是 OTLP/gRPC 與 OTLP/HTTP。它可以出現在應用到 Collector,也可以出現在 Collector 到後端的連線上;Transport 並非只存在於中間的一個節點。來源:OTLP Specification
使用共同協定能降低應用對特定後端的耦合,接收端仍要支援相同訊號、編碼、端點與認證。Prometheus scrape、remote write、Loki API 和 profiling 接口也可能並存,不能把整套 Grafana 生態都畫成 OTLP。
④ Collection / Processing:如何接收、處理與轉送?
OpenTelemetry Collector 的基本模型是 Receiver → Processor → Exporter。Receiver 可以接收推送,也可以主動採集;Processor 依需要處理批次、欄位或過濾,Exporter 再送往目的地。Processor 是可選的,而且各元件要支援所在 pipeline 的訊號。來源:Collector Architecture
這次使用的 Alloy 把 OTel、Prometheus、Loki 與 Pyroscope 等元件接成資料流。Batch、Filter 或 trace sampling 各有不同用途,不能把所有 processor 無差別套到每種信號。Collector 是常見的集中處理方式,後端相容時也可由 SDK 直接輸出,不是每個部署都必須多一跳。
⑤ Backend / Analysis:如何保存、查詢並理解?
在本專題的工具組合中,Mimir、Loki、Tempo、Pyroscope 分別承接 Metrics、Logs、Traces、Profiles;其他架構也可能使用 Prometheus、Jaeger 或商業平台。Grafana 向資料來源查詢,提供視覺化、關聯與告警入口。
OpenTelemetry 的責任,是協助產生、描述、傳輸與處理 telemetry;儲存與視覺化交由其他工具。共同標準能降低耦合,查詢語言、保留策略與資料模型轉換仍有平台差異。來源:What is OpenTelemetry?
因此,三層到五層的對應可以這樣記:
- Produce:① 埋點產生資料;② Signals 描述資料,並貫穿後續流程。
- Collect:④ 收集與處理;③ Transport 連接資料來源、Collector 和後端。
- Consume:⑤ 保存、查詢、分析與視覺化。
回到這次 Lab,Traces 經 OTLP 進入 Alloy,Metrics 由 Alloy scrape 後 remote write 到 Mimir,Logs 使用 Loki API,Profiles 走 Pyroscope 接口。五個面向幫助我們讀懂這些不同路徑,而不是把已實跑環境改寫成全 OTLP 的假想部署。
三大支柱描述資料種類,三層模型描述工作階段,五層拆法幫助定位責任。 前面的六個演進階段則回答能力如何累積,是另一個維度。
Grafana Labs:先理解每個工具的責任
Grafana Labs 的產品很多。學習時,我會先按責任把它們放回資料流:
| 責任 | 工具 | 在這條學習路線的用途 |
|---|---|---|
| 收集與處理 | Alloy | 接收、處理並轉送 telemetry |
| 儲存與查詢訊號 | Mimir、Loki、Tempo | 分別處理 Metrics、Logs、Traces |
| 調查入口 | Grafana | 查詢、視覺化、關聯與告警 |
| 受控驗證 | k6 | 用可重複負載比較故障前後 |
| 深入程式成本 | Pyroscope | 持續收集與分析 profiles |
| 瀏覽器體驗 | Faro | 觀察前端錯誤、體驗與請求 |
| 補充自動埋點 | Beyla | 利用 eBPF 增加部分服務的可見性 |
| 管理部署配置 | Tanka | 以 Jsonnet 管理 Kubernetes 設定 |
產品定位可由 Grafana Labs 開源專案頁 查閱。上表的學習順序是我的整理,並非官方的必裝清單。
這次 Lab 的主要路徑是:應用產生訊號,Alloy 收集後分流到不同後端,再由 Grafana 查詢。k6 從外部發出受控請求。Tanka 屬於部署配置管理,不在請求或 telemetry 的傳送路徑上。
我的建議是先完成 Metrics、Traces、Logs 的調查鏈,再按問題加入其他工具。需要理解瀏覽器體驗,研究 Faro;需要理解程式資源消耗,研究 Pyroscope。每增加一個元件,都要知道它補上哪個資訊缺口。
一個 DB lock,讓學習有了驗收標準
這次 Lab 以 Grafana 官方 intro-to-mltp 為基礎,固定上游版本,依序執行正常、資料庫鎖定、恢復三個階段。
每個階段使用相同的 k6 設定:每秒 2 次指定 API 請求,持續 30 秒,client timeout 為 3 秒;Lab 另有背景流量。故障注入是在隔離教學環境維持約 20 秒的資料表鎖定。
2026 年 9 月 19 日的實測結果:
| 階段 | k6 P95 延遲 | client 失敗率 |
|---|---|---|
| 正常 | 7.33 ms | 0% |
| DB lock | 3001.82 ms | 62.30% |
| 恢復 | 8.59 ms | 0% |
來源是本次 Lab 保存的三階段 k6 結果,並非 Grafana 官方 benchmark。這個實驗用來檢查故障與恢復模式,不能用來推論產品容量、正式環境 SLO,或平台之間的效能優劣。
調查時,先用指標與測試結果界定時間窗,再搜尋慢 trace,找到耗時的資料庫操作,並以同一 trace ID 查詢 logs。
這時仍需要問:什麼證據支持「資料庫鎖等待」?
本次的答案包括已記錄的鎖定交易、請求在資料庫操作上的等待,以及解除鎖定後、相同測試設定下的恢復。若只有一段很長的 DB span,其他可能原因仍需保留。
還有一個很值得練習的細節:client 在約 3 秒 timeout,server 端的一條代表 trace 卻持續約 18.38 秒。Client 停止等待後,server 的工作可能仍在繼續。因此,兩端延遲不能直接當成同一個量測值。
Profiles 在本次只驗證到服務與時間窗層級的可用資料;未驗證每條 span 的 profile 關聯。Beyla 與 Tanka 留作選修,尚未實跑。
我的學習順序:每一步都留下可檢查的成果
我會把第一輪練習安排成五個動作:
- 選一條使用者路徑。 定義成功、失敗、延遲及量測位置。
- 讀懂正常狀態。 保存正常請求的指標、trace 與 logs,確認 context 能對上。
- 在隔離環境注入一個可恢復故障。 設定時間上限、清理方式與停止條件。
- 先寫假設,再查證。 記錄支持與反對證據,區分耗時位置和原因。
- 用相同條件驗證恢復。 保留查詢、時間窗與結果,讓另一位工程師可以重走一次。
對團隊而言,這份練習也會暴露一些責任問題:誰維護埋點?誰決定欄位與保存期限?誰確認版本更新後關聯仍然有效?
工具越多,採集、儲存、查詢、升級與教學成本也會增加。我的採用判準是:新增資料能否回答目前的重要問題,而團隊是否有能力維護它。
✅ 能從症狀找到一筆具體請求。
✅ 能解釋證據支持什麼,也知道它沒有證明什麼。
✅ 能讓同事重現查詢與恢復驗證。
📌 把一次故障解釋清楚,會讓下一次架構決策多一份依據。
AI 可以協助產生埋點、查詢與候選假設。工程師仍要理解量測邊界,並核對執行結果。這也是我希望從 Observability 練到的能力。
下一次 API 變慢時,你的團隊能從第一個警訊,一路追到足以採取行動的證據嗎?
延續閱讀相關文章,沿著同一組技術脈絡繼續往下看。
在談 scale 之前,我更在意 operability
為什麼發版流程、可觀測性與除錯習慣,應該比平台複雜度更早成形。
AI Agent 的三個迴圈:從 ReAct、Reflexion 到 Generative Agents
從 ReAct、Reflexion 與 Generative Agents 理解行動、回饋與記憶,對照 Heptabase、Codex 到網站發佈的實作選擇與驗收問題。
我的 AI 工作流減法:讓知識、任務與發佈各有歸屬
退役自製 Content Studio 後,我如何讓 Zotero、Heptabase、Linear、Codex 與 Git 各自承接文獻、知識、任務、執行和發佈,並保留圖片與全文審閱的最後一步。