2026年9月20日
PillarAI 產生學 Observability,請親手追完一次故障
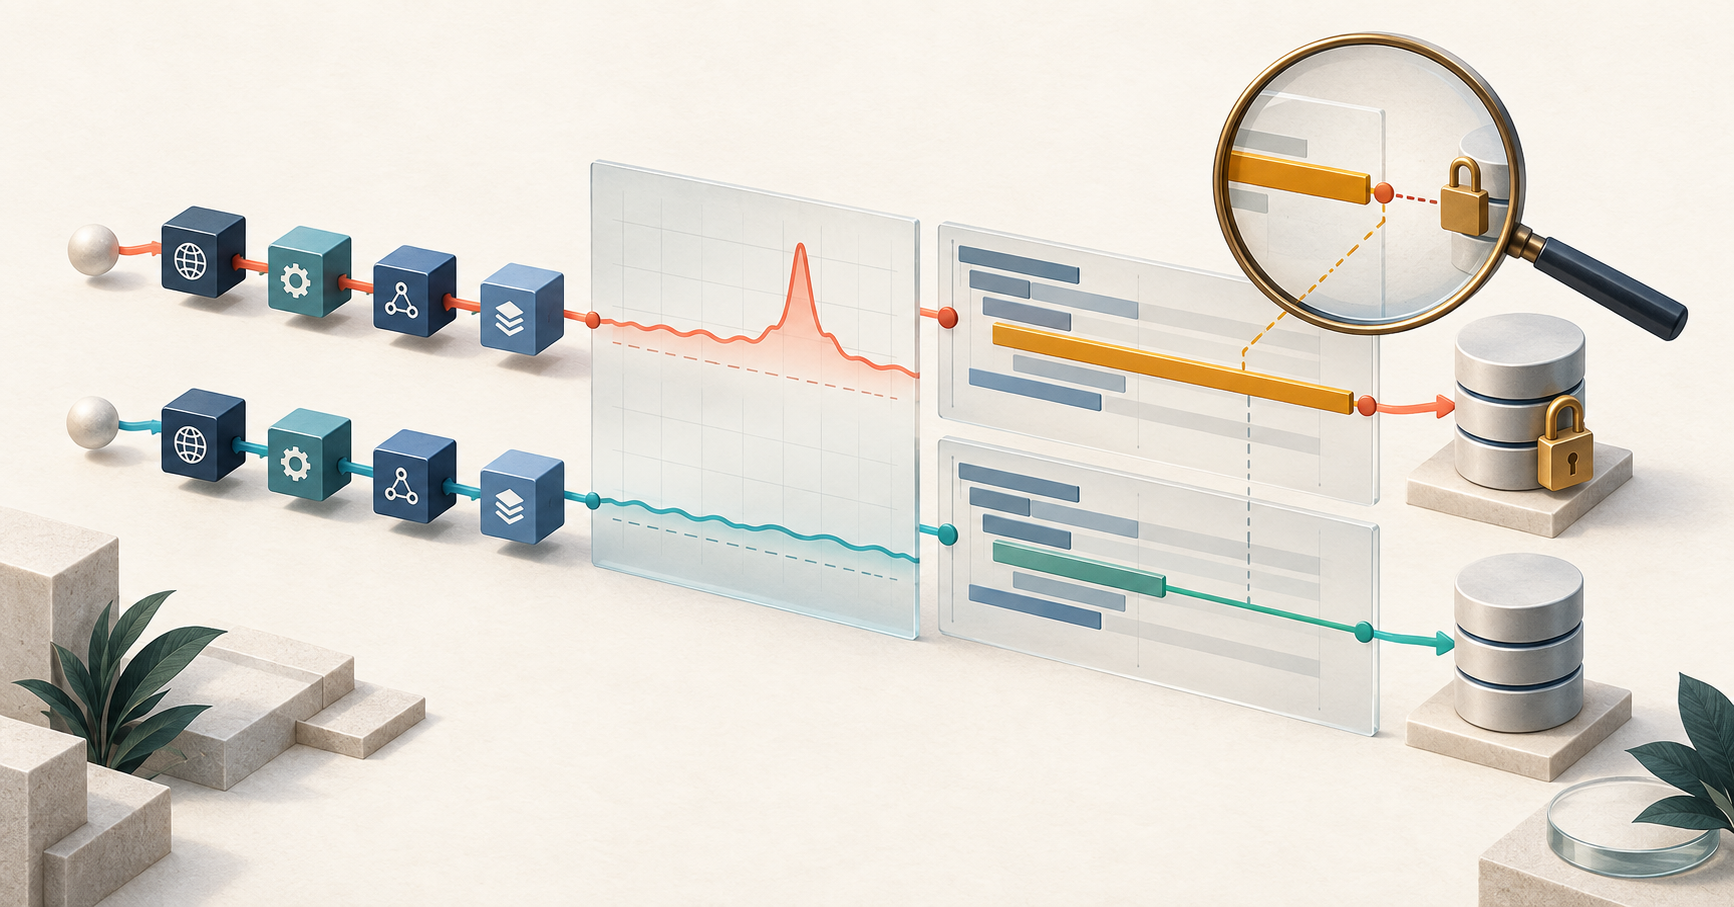
從一次可重現的 DB lock 實驗,理解 Monitoring 與 Observability 如何互補、六個演進階段、Grafana Labs 工具分工,以及從症狀到恢復驗證的學習方法。
10 分鐘閱讀Open /
ObservabilityOpenTelemetryGrafanaSoftware ArchitectureEngineering Practice
聚焦 platform architecture、operability、engineering delivery 與可維運系統的思考與實作取捨。
從一次可重現的 DB lock 實驗,理解 Monitoring 與 Observability 如何互補、六個演進階段、Grafana Labs 工具分工,以及從症狀到恢復驗證的學習方法。
從 ReAct、Reflexion 與 Generative Agents 理解行動、回饋與記憶,對照 Heptabase、Codex 到網站發佈的實作選擇與驗收問題。
退役自製 Content Studio 後,我如何讓 Zotero、Heptabase、Linear、Codex 與 Git 各自承接文獻、知識、任務、執行和發佈,並保留圖片與全文審閱的最後一步。

模型讓生成答案變得便宜,也讓團隊更容易在錯誤方向上快速前進。要把 AI 從聊天工具變成交付能力,關鍵不是累積更多 prompt,而是建立可版本化的問題規格、資訊缺口管理與驗收迴路。

一次有效的回饋,不只要讓人願意說真話,還要把事實、界線與承諾留在系統裡。從安全感、具體行為到引導與教導的動態切換,這是一套能被追蹤、除錯與持續改善的管理迴路。
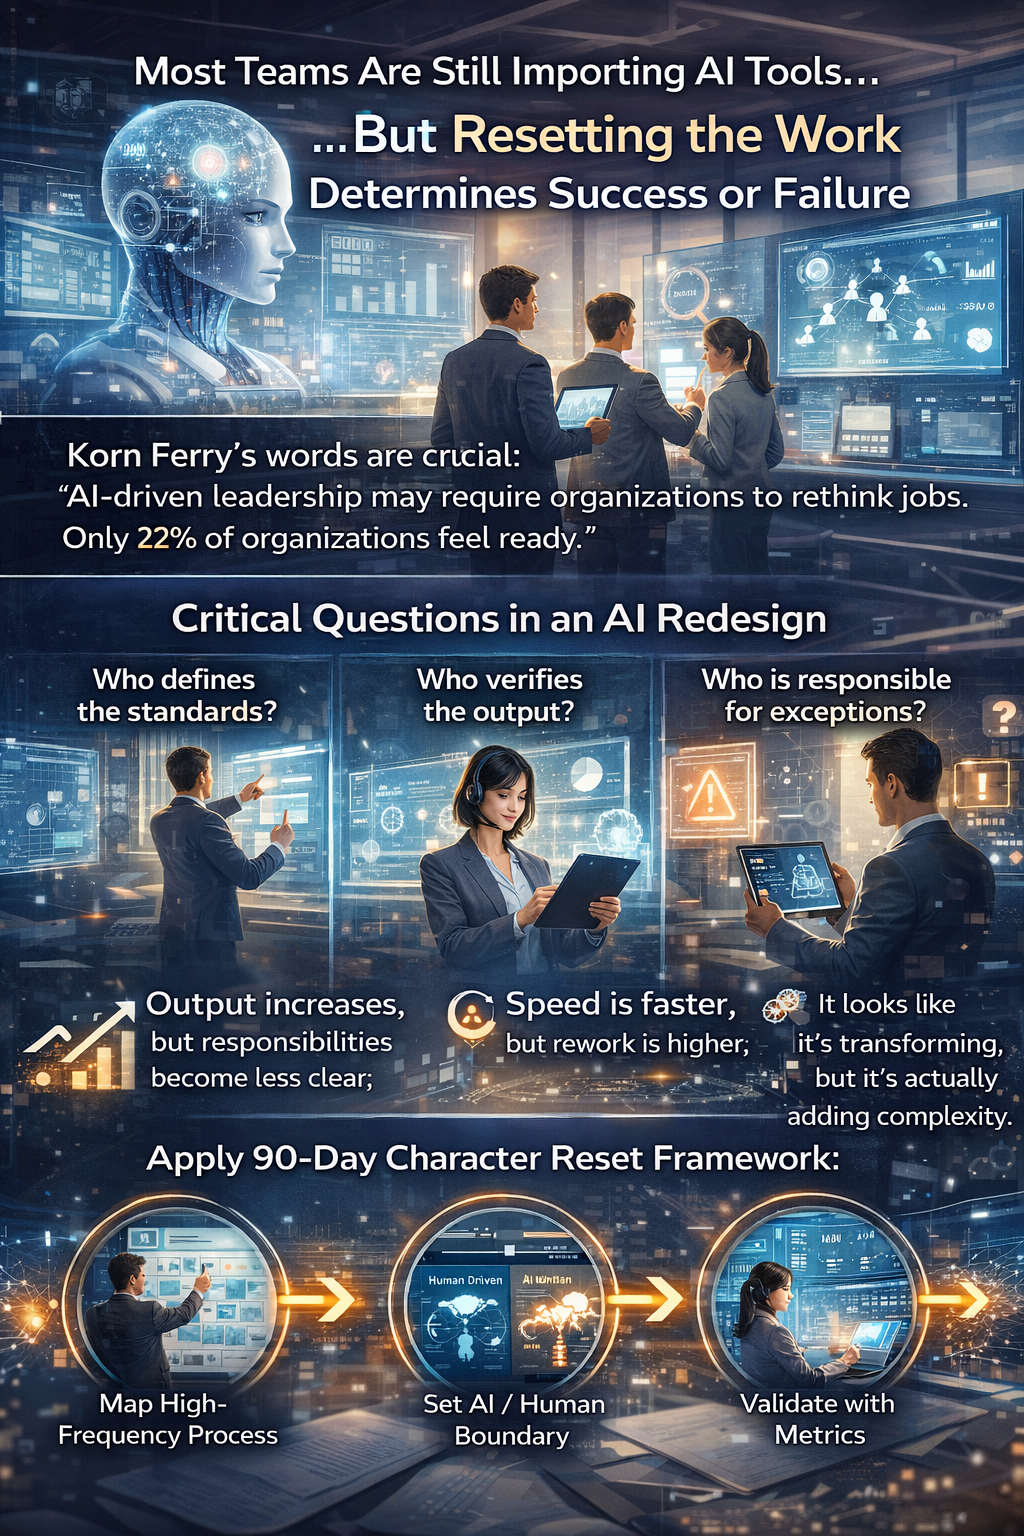
Korn Ferry 提到只有 22% 組織認為自己準備好做 job redesign。這個訊號真正指向的,不是工具成熟度,而是管理任務已經改寫:下一波競爭在角色設計、驗證鏈路與責任閉環。
最近在 LinkedIn 上,人才與 HR operator 主導的 AI 閱讀清單,正把技術訊號翻譯成管理語言。這不是單純資訊整理,而是企業開始用政策、流程與責任框架來吸收 AI 的明確前兆。
GitHub Superpowers 在 2026-03-24 的流程調整,揭示了 agentic 開發的核心戰場已從模型表現轉向流程治理。真正可複製的優勢,是把 spec 到 release 變成可觀測、可回放、可簽核的交付節奏。
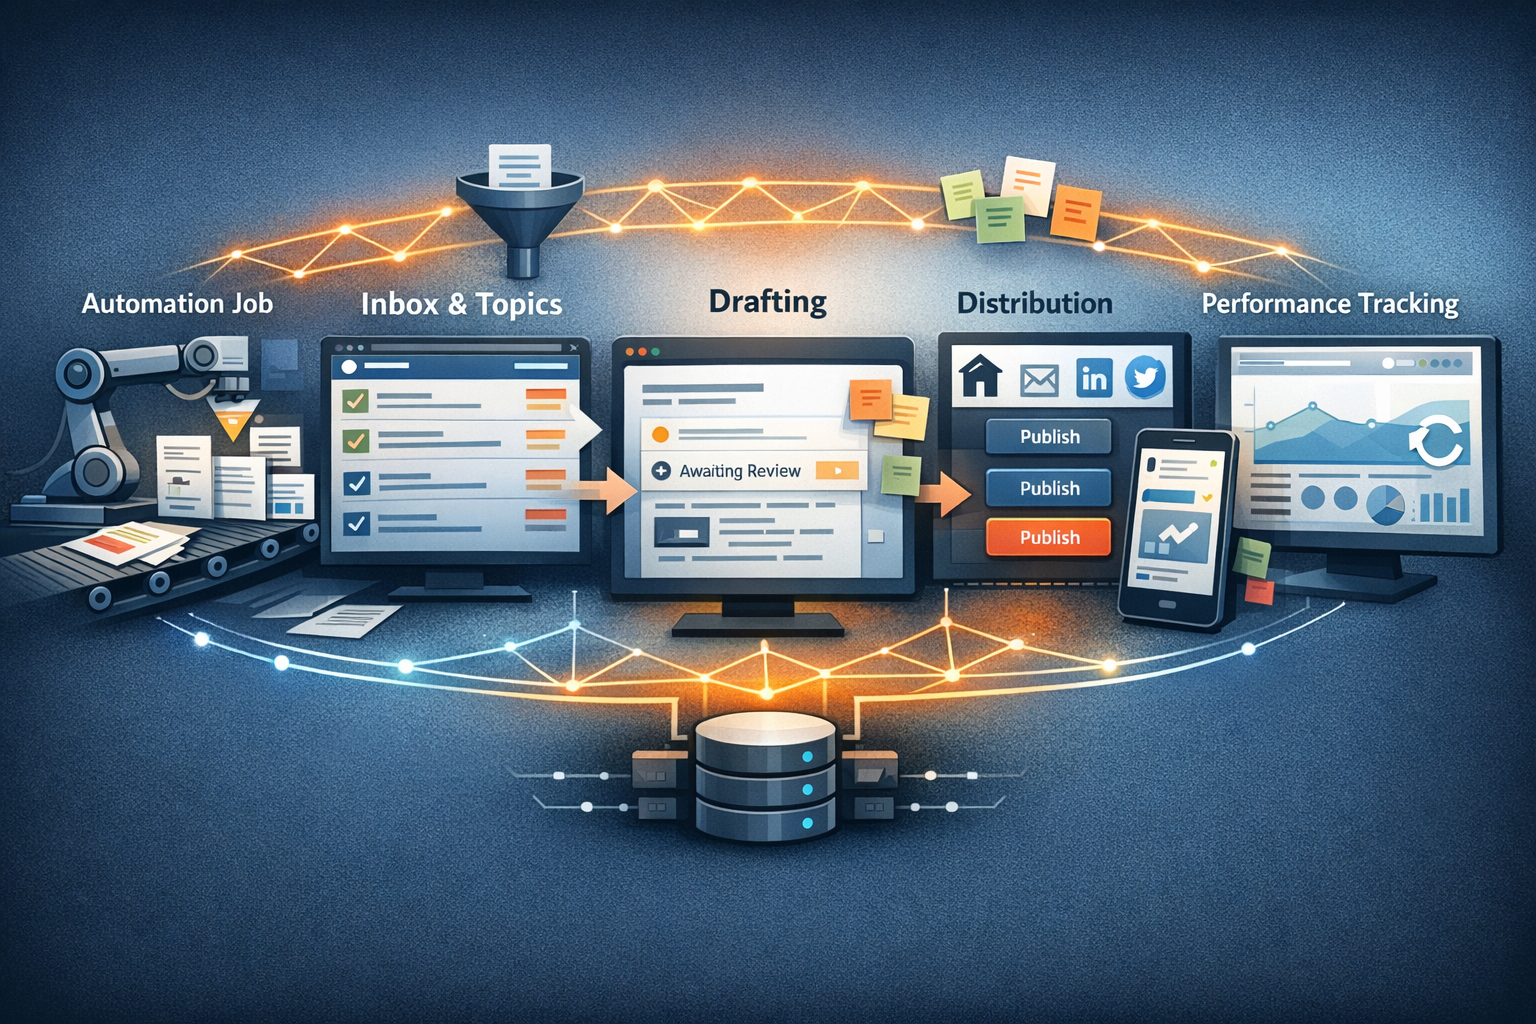
AIPW 真正被產品化的,不是 AI 幫你寫文章,而是把 automation、Inbox、Topics、Drafting、Distribution、Performance 收斂成同一條 article-centric workflow,讓 personal-site growth 從零散操作變成可治理、可觀測、可優化的內容系統。
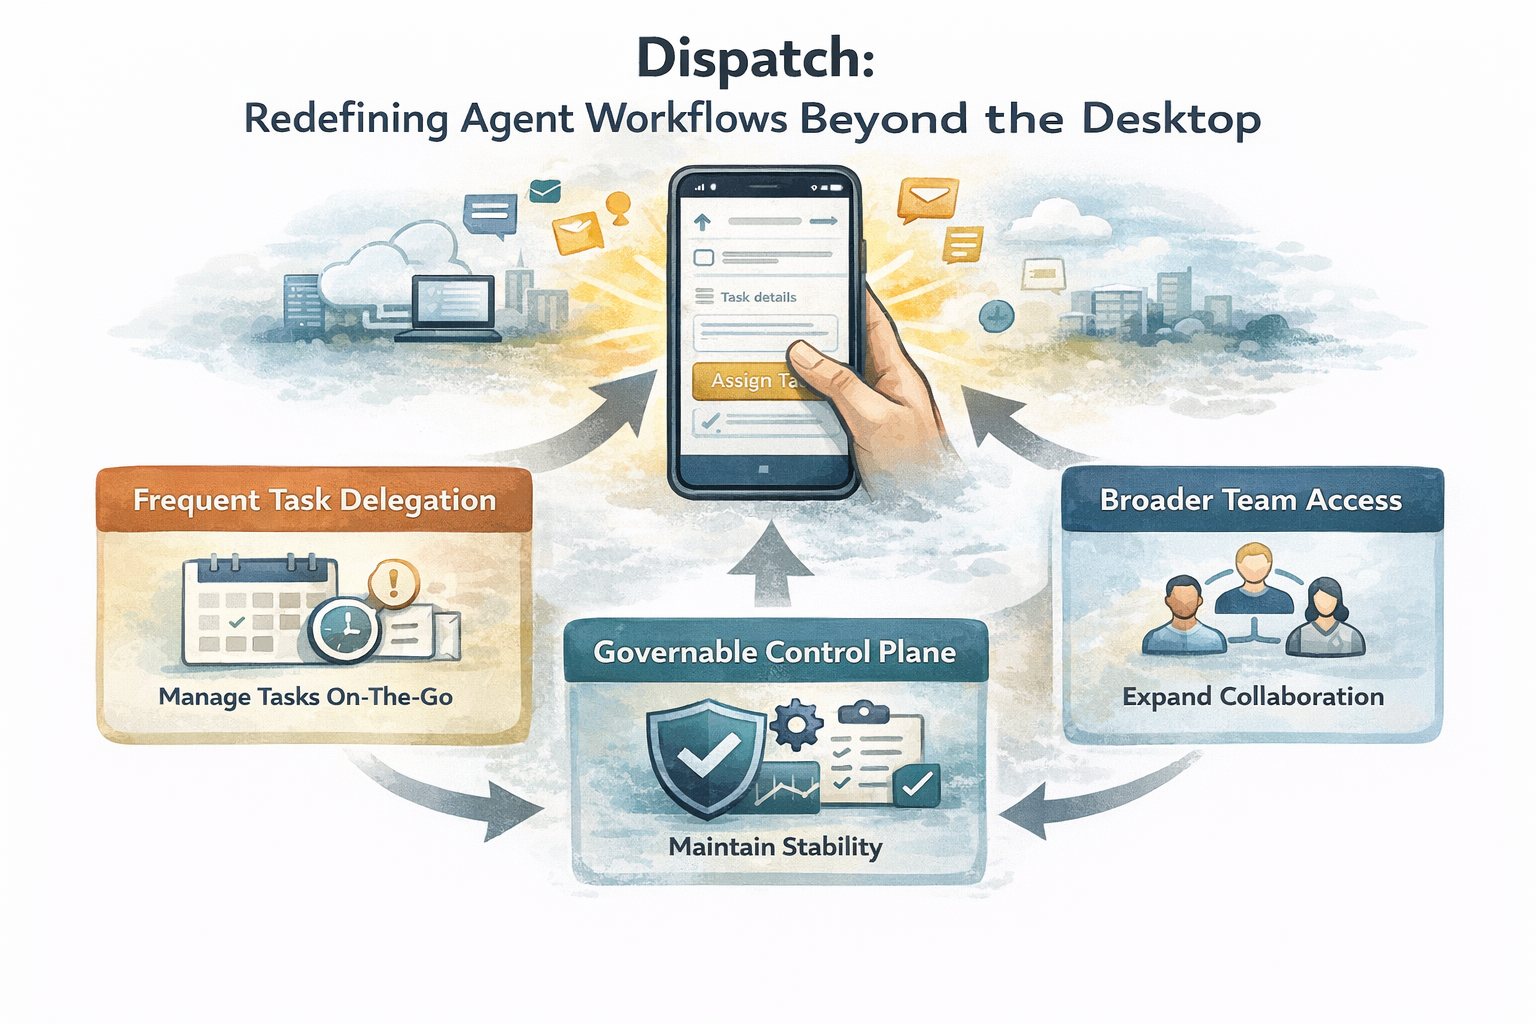
Anthropic 的 Dispatch 看似只是多一個手機入口,實際上改變的是 agent 的使用節奏與組織責任分工。當委派變得即時,治理缺口也會被提前放大;團隊要先補的是權限、狀態可見性與接手機制,而不是急著追求更高自動化覆蓋率。
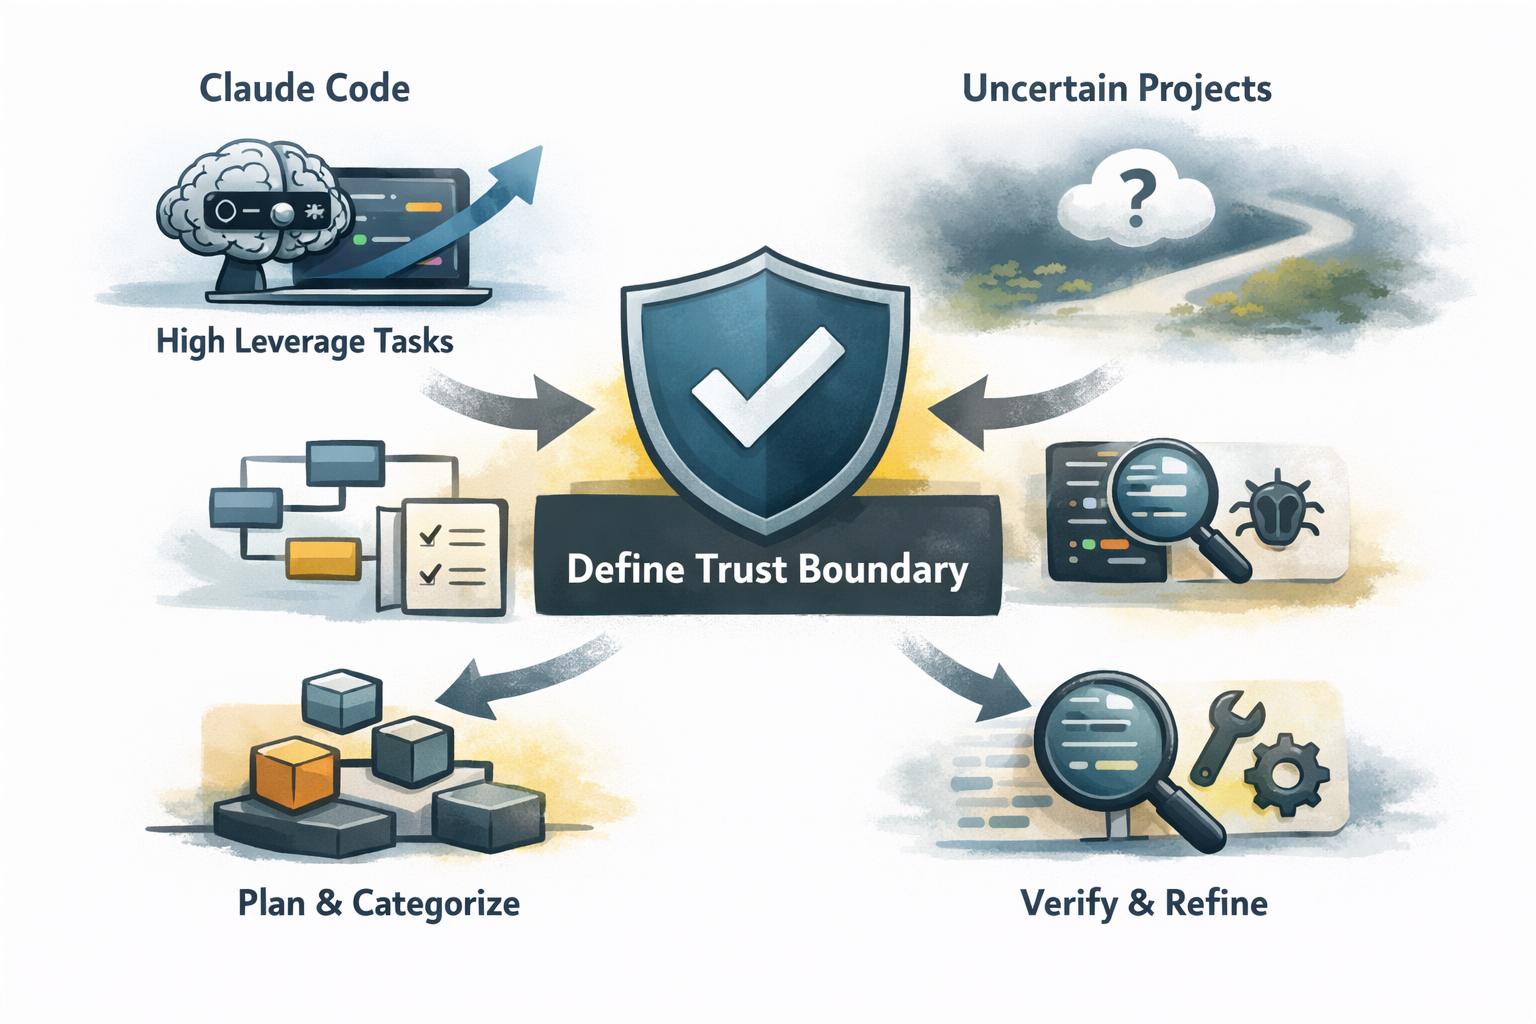
Claude Code 的導入成效,差異常常不在模型本身,而在團隊是否先定義任務邊界與驗證機制。當問題可驗證,AI coding 會帶來穩定吞吐;當需求仍漂移,速度很快就會轉成 review 與返工債務。
Vercel Chat SDK 的真正價值不是再做一個 bot framework,而是把跨平台 distribution 成本標準化,讓團隊更快驗證哪些聊天入口值得長期投入。
三月以來,社群對 Vibe Coding 的焦點從「做得快」轉向「誰來負責」。當 prototype 被誤認成 product,團隊省下的開發時間,往往會在維運、返工與交接成本中加倍吐回去。
當 AI 把寫碼速度推到新高,團隊最深的瓶頸反而更早浮現:需求邊界不清、驗收不可執行、責任無法追蹤。這篇從 Replit 討論擴散談起,拆解為什麼複雜產品的競爭點正在回到 spec、ownership 與 observability。

GitHub 這次升級真正改變的不是評論量,而是評論前的理解流程:context-aware review 會成為下一階段 AI code review 的基本門檻。

`agency-agents` 真正的訊號不是「又多了一堆 AI 角色 prompt」,而是 agent 圈開始把「專家規格 + 跨工具分發 + 協作敘事」做成可複用產品。

真正值得注意的不是回寫功能本身,而是它把設計與程式碼拉回同一條可追蹤 artifact 鏈,讓團隊可以系統化處理漂移、衝突與交付一致性。

2026 年 AI coding 的關鍵競爭,不再是誰先接到新模型,而是誰先把 Agent 做成可觀測、可驗證、可維運、可交付的工程系統。

這不是多一個搜尋 API,而是把官方 docs 納入 agent 生產鏈的 truth layer;競爭點會從模型回答能力,轉向知識來源可追溯性與營運可控性。

GPT-5.4 把 agent execution 與 professional work 放進同一條產品主線,競爭焦點因此從模型跑分,轉向誰能更穩定地把任務完成率、治理與可維運性產品化。

對多數團隊,`AGENTS.md` 類常駐 context 應是預設層,skills 與 retrieval 應是補充層;競爭焦點正從「更會查」移到「更不會忘」。

Copilot CLI GA 真正重定義的不是 CLI 工具,而是工程團隊的人機分工:競爭點從誰能產生程式碼,轉向誰能在 terminal 中把權限、可觀測性與回滾機制做成可規模化的日常。

這波更新的本質不是功能堆疊,而是把 IDE chat 升級為可規劃、可隔離、可路由模型、可接外部能力的交付工作台;競爭點會從「誰能多寫一點」轉向「誰能把多代理流程穩定交付與維運」。

GPT-5.4 真正推進的不是單一 benchmark,而是團隊如何把 AI 納入可維運、可觀測、可驗收的交付流程。

真正值得注意的不是『哪些工作會被取代』,而是企業現在可以用可觀測指標管理 AI 導入:把採購、培訓、流程改造與風險治理放進同一套決策系統。

真正值得注意的不是 Cloudflare 多了一個輸出格式,而是 web 內容正式出現「機器優先入口」:先把輸入介面做對,常比再堆 prompt engineering 更有效。

Storage Buckets 不是小功能,而是 Hugging Face 從 repo 中心升級為 artifact 中心的基礎設施訊號;競爭點正在轉向誰能把 artifact 流做得更低摩擦、可觀測、可維運。

這個專案最重要的不是把模型訓練自動化,而是把研究組織邏輯轉成可版本化 workflow;競爭點正從模型調參技巧移向迭代系統設計能力。

OpenClaw 的關鍵意義是把 AI workflow 從提示工程拉到執行治理:值得產品化的是 onboarding、routing、policy 與 audit;仍需人工核發的是跨帳號高風險與破壞性動作。

`autoresearch` 真正改變的不是「AI 能不能做研究」,而是「研究 agent 首次以可複製流程進入團隊日常評估清單」,競爭焦點將轉向可維運性與評估治理。

Meta 收購 Moltbook 的關鍵不在產品體量,而在於用併購加速拿到可複用的 agent 角色化與社交化介面;下一波 AI agent 競爭會從模型層延伸到可營運的產品面與分發面。

競爭焦點正在從「模型輸出品質」轉向「工作流程是否可觀測、可治理、可穩定交付」,而 runtime 選型將成為架構級決策。

真正重要的不是新增一個 plugin,而是 Vercel 把 knowledge graph、context injection、specialist agents、validation hooks 打包成 AI-native DX 控制面,正在重寫 developer platform 的護城河定義。

真正可用的 agent editor,不是只會做事,而是把自治權限與除錯觀測做成可日常運作的 control plane。

從架構、交付方式到可維運規則,談 First Horizon 的起手式。